eISSN: 2093-8462 http://jesk.or.kr
Open Access, Peer-reviewed
eISSN: 2093-8462 http://jesk.or.kr
Open Access, Peer-reviewed
Yu Jun Lee
, A-Ran Lee
, Kyung-Sun Lee
10.5143/JESK.2026.45.5.593 Epub 2026 November 08
Abstract
Objective: The aim of this study is to develop an accident cause taxonomy that enables the objective and consistent collection and classification of accident causes using BERTopic.
Background: As industries continue to develop, safety management systems for preventing accidents and occupational diseases have become increasingly important. Accident cause analysis is a key means of identifying the direct and indirect factors leading to accidents and preventing the recurrence of similar accidents. However, existing accident cause analysis methods differ in their perspectives, procedures, and the range of factors considered, which may lead to different analytical outcomes even for the same accident.
Method: In this study, accident cause data were collected from 26 existing accident cause analysis methods and 10 checklists. To identify the optimal BERTopic model, various combinations of embedding models, key parameters, and evaluation metrics were compared. Based on the optimal model, initial topic modeling was performed. Subsequently, re-clustering and qualitative review by the researcher were conducted to refine the topics and ultimately establish the accident cause taxonomy.
Results: Based on the comparative analysis of various modeling combinations, the configuration using the all-mpnet-base-v2 embedding model, n_gram_range=(1,1), top_n_words=25, and min_topic_size=15 was identified as the optimal model. Initial topic modeling was then performed based on the optimal BERTopic model, resulting in a total of nine topics. Subsequently, reclustering was conducted on three topics whose clusters contained 50 or more words. Finally, an accident cause taxonomy consisting of 5 top-level factors, 17 sub-factors, and 27 detailed factors was derived.
Conclusion: The proposed system provides a structured framework for systematically identifying and classifying accident causes.
Application: The findings of this study can be used as foundational data for standardizing accident cause taxonomies, systematically accumulating and comparing accident cause data, and developing effective recurrence prevention measures.
Keywords
Accident cause Taxonomy BERTopic Industrial safety and health
산업발전과 기술혁신에 따라 작업환경의 안전성, 노동생산성, 산업안전보건 체계와 예방 중심의 안전관리 체계가 지속적으로 고도화되고 있다(Arana-Landín et al., 2023; Bettiol et al., 2024; Dyreborg et al., 2024). 이러한 발전에도 불구하고 산업현장에서 발생하는 재해는 여전히 근로자의 생명과 건강을 위협하는 주요한 사회적 문제로 대두되고 있다(Takala et al., 2024). Ministry of Employment and Labor (2026)의 통계자료에 의하면, 2025년 산업현장에서 사고로 인하여 사망한 사망자수는 605명으로 전년 대비 16명 증가하였으며, 사고 사망 건수도 573건으로 전년 대비 20건이 증가하였다. 이는 산업발전과 기술혁신에 따라 안전기술과 체계가 고도화됨에도 불구하고 다양한 새로운 유해 · 위험요인이 발생하여 산업재해의 위험이 완전히 제거될 수 없기 때문에 지속적인 예방 및 관리 활동이 필요하다는 것을 시사한다(Dyreborg et al., 2024; Takala et al., 2024). 산업현장에 존재하는 유해 · 위험요인을 지속적으로 관리하기 위해서는 사고 발생 원인과 발생 메커니즘을 체계적으로 분석하는 과정이 무엇보다 중요하다(ILO, 2015; Morrish, 2017; Ferjencik et al., 2023). 따라서 사고조사 과정은 산업현장에 현존하는 문제들을 지속적으로 예방 및 관리하여 작업환경의 안전성을 향상시키고, 산업재해로 인한 인적 및 물적 손실을 최소화하는데 중요한 과정이다(ILO, 2015; OSHA, 2016; Morrish 2017).
사고 발생의 원인과 발생 메커니즘을 체계적으로 분석하기 위하여 HFACS (Human Factors Analysis and Classification System), AcciMap (Accident Map), RCA (Root Cause Analysis), STAMP (System-Theoretic Accident Model and Processes) 등 다양한 기법들이 활용되고 있다. HFACS는 조직적 사고원인 모델에 기반하여 사고에서 나타나는 인적 오류와 그 기저요인을 체계적으로 분류 · 분석하기 위해 개발된 기법이며(Wiegmann and Shappell, 2001), AcciMap은 복잡한 시스템 내에서 정책, 조직, 현장 등 다양한 계층 간의 상호작용을 종합적으로 분석하기 위해 개발되었다(Waterson et al., 2017; Igene et al., 2022). RCA는 사고나 문제의 근본 원인과 시스템적 요인을 식별하고, 이를 바탕으로 개선조치 및 재발방지대책을 도출하기 위한 기법으로, 의료, 공정안전, 원자력 등 다양한 안전관리 분야에서 폭넓게 활용되고 있다(Martin-Delgado et al., 2020; Khodadadi-Mousiri et al., 2023; Song et al., 2023). STAMP는 사고를 개인의 실수나 장비 고장만의 결과로 보지 않고, 조직의 관리, 의사결정, 안전관리 체계 등 시스템 전반의 문제를 함께 분석하는 기법으로, 시스템의 복잡도와 위험도가 높은 산업 분야에서 활발하게 활용되고 있다(Düzgün and Leveson, 2018). 위에 소개한 사고원인 분석기법들은 서로 다른 이론적 관점과 분석 범위를 바탕으로 사고의 원인을 체계적으로 검토할 수 있는 분석 틀과 주요 요인을 제공한다. 한편, 실제 사고조사 과정에서는 사고원인을 확인하기 위한 별도의 체크리스트(Checklist)가 활용되기도 하며, 이러한 체크리스트는 조사자가 주요 원인요인을 체계적으로 검토하고 일관된 자료를 수집하는 데 도움을 줄 수 있다(Concha-Torre et al., 2020).
그러나 현재 활용되고 있는 사고원인 분석기법은 대상, 범위 및 관점에서 서로 다른 특징을 가지고 있어 동일한 사고사례에서도 도출되는 사고원인과 그 중요도에 대한 해석이 달라질 수 있다(Kee, 2017; Hyun et al., 2020; Igene and Johnson, 2020; Hulme et al., 2024). 이러한 차이는 동종재해의 재발방지대책 수립 과정에서 중요한 문제로 작용한다. 실제로 중대한 사고 가능성을 지닌 위험요인의 중요도가 과소평가될 경우 적절한 예방조치가 미흡해질 수 있으며, 반대로 과대평가될 경우 불필요한 자원과 노력이 투입될 수 있다(Vatanpour et al., 2015; Hulme et al., 2024). 이러한 맥락에서, 최근 선행연구들은 기존에 활용되고 있는 사고원인 분석기법을 종합적으로 검토함으로써 각 기법의 명확한 한계가 존재함을 지적하고 있다. Porter et al. (2025)는 AcciMap, HFACS, Causal Analysis based on Systems Theory (CAST), Functional Resonance Analysis Method (FRAM) 등 주요 사고원인 분석기법을 검토한 결과, 대부분 오류, 실패, 결함과 같은 실패요인에 초점을 두는 경향이 있으며, 시스템 전반에서 나타나는 복잡한 상호작용을 충분히 설명하는 데 한계를 지닌다고 보고했다. 또한 Wong and Pawlicki (2025)는 RCA, London Protocol, AcciMap, CAST 등 다양한 사고분석기법을 검토한 결과, 분석기법이 전제하는 사고모델과 분석 범위에 따라 도출되는 사고원인과 개선대책이 상이할 수 있으며, 각 분석기법은 고유한 강점과 한계를 지닌다고 보고했다. 이러한 결과를 종합해보면, 일관되고 객관적으로 사고원인을 분석하기 위한 명확한 표준 체제의 확립이 필요함을 시사할 수 있다.
이를 위해서는 전문가의 주관적 판단에 의존하는 정성적 분류체계가 아니라, 다양한 데이터를 기반으로 사고원인을 효율적으로 체계화할 수 있는 데이터 기반의 정량적 분류체계가 요구된다(Tixier et al., 2016; Khairuddin et al., 2022). 특히 산업환경의 변화와 사고유형의 다양화로 인해 분석대상 데이터의 규모와 복잡성이 확대되고 있으며, 기존의 분류 방식만으로는 분석 효율성과 분석자 간 해석의 일관성이 충분히 확보되기 어렵다(Baker et al., 2020; Hulme et al., 2024). 따라서 대규모 비정형 텍스트 데이터에 내재된 주제 구조를 도출하고, 의미적으로 유사한 데이터를 체계적으로 군집화할 수 있는 토픽 모델링 기법을 활용할 필요가 있다. 이를 통해 기존 전문가 중심의 정성적 분류체계를 실제 데이터 기반의 객관적 · 정량적 분류체계로 발전시킬 필요가 있다.
토픽 모델링 기법 중 BERTopic은 최근 활용이 확대되고 있는 임베딩 기반의 토픽 모델링 방법론이다(Egger and Yu, 2022). Latent Dirichlet Allocation (LDA)는 문서 내 단어의 출현 패턴에 기반한 Bag-of-Words 접근을 사용하기 때문에 짧은 텍스트의 문맥 정보를 충분히 반영하는 데 한계가 있으며(Blei et al., 2003; Wallach, 2006; Qiang et al., 2016), Top2Vec은 단어와 문서를 동일한 의미 벡터 공간에 임베딩하여 의미적 유사성에 기반한 토픽을 도출하지만, 임베딩 모델의 품질과 데이터의 언어, 도메인, 문서 길이 등의 특성에 따라 결과의 해석 가능성이 달라질 수 있다(Angelov, 2020; Egger and Yu, 2022). 반면 BERTopic은 사전에 학습된 Transformer 기반 임베딩을 활용하여 텍스트의 의미 정보를 벡터화하고, 이를 Uniform Manifold Approximation and Projection (UMAP)을 통해 저차원 공간에 투영한 후 Hierarchical Density-Based Spatial Clustering of Applications with Noise (HDBSCAN) 기반 군집화를 수행한다. 이러한 과정은 문서 간 의미적 유사성과 문맥 정보를 반영하는 데 유리하므로, 짧은 문장으로 구성된 텍스트 데이터에서도 해석 가능성이 높은 토픽을 도출할 수 있다는 강점을 지닌다(Grootendorst, 2022; Egger and Yu, 2022). 따라서 다양한 사고 데이터에 내재된 의미 구조를 도출하고, 객관적 · 정량적 분류체계를 구축하는 데 적합한 방법론으로 활용될 수 있다.
따라서 본 연구의 목적은 문헌조사를 통하여 다양한 사고원인 분석기법과 체크리스트에서 정의하고 있는 사고원인 데이터를 수집하고, 이를 BERTopic 기법을 활용해 객관적이고 구조화된 사고원인 분류체계를 도출하는 방법론과 항목을 제안하는 것이다.
2.1 Overall research procedure
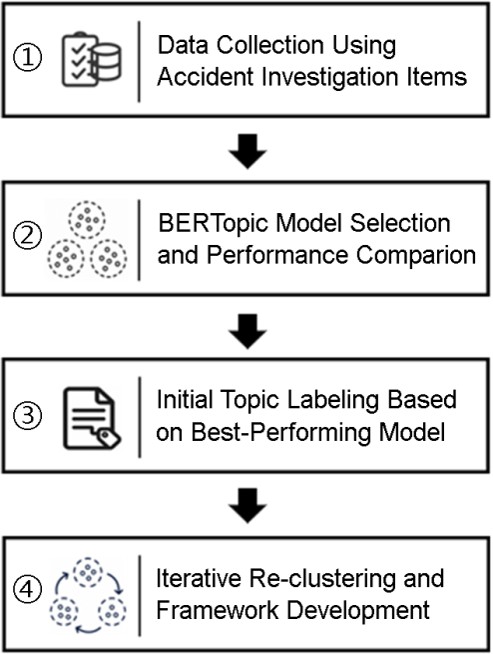
본 연구는 데이터 기반의 사고원인 분류체계를 도출하기 위해 총 4단계의 절차로 구분하여 진행하였다. 첫 번째로, 기존에 활용되고 있는 사고원인 분석기법과 체크리스트를 바탕으로 사고원인 데이터를 수집하였으며, 이를 기반으로 데이터 정제 과정을 수행하였다. 두 번째로, BERTopic 관련 선행연구를 바탕으로 임베딩 모델, 주요 파라미터, 평가지표를 최종적으로 선정한 뒤, 다양한 조합의 평가지표 값을 바탕으로 성능을 비교하였다. 최종적으로 평가지표의 성능이 가장 좋은 최적의 조합을 선정하여 BERTopic 모델링을 수행하였다. 세 번째로, 선정된 BERTopic 모델링을 통해 도출된 각 군집의 의미를 해석하고 적합한 토픽명을 설정하였다. 마지막으로, 군집 내 항목 수가 과도하게 많다고 판단되는 군집에 대해서 재군집화를 수행했으며, 정량적 분석만으로 구조화하기 어려운 군집은 선행연구의 접근을 참고하여 연구진 3인의 정성적 검토를 통해 재군집화를 실시하였다(Ferizaj et al., 2025). 이러한 과정을 통해 최종적으로 사고원인 분류체계를 구축하였다(Figure 1).
2.2 Data collection
본 과정에서는 기존 문헌 및 실무에서 활용되고 있는 사고원인 및 안전분석 관련 기법과 사고조사 체크리스트 자료를 바탕으로 사고원인 관련 데이터를 수집하였다. 사고원인 및 안전분석 관련 기법은 사고원인, 기여요인, 인적 오류, 설비 고장 및 시스템적 요인 등 사고 발생과 관련된 분석요소를 제시하고, 이를 텍스트 형태로 추출할 수 있는 기법과 모형을 대상으로 선정하였다. 또한 사고조사 체크리스트 관련 자료는 사고조사 과정에서 사고원인 및 기여요인을 확인하기 위한 질문이나 점검항목을 포함하는 문헌과 실무자료를 대상으로 수집하였다. 최종적으로 26개의 사고원인 분석기법과 10개의 체크리스트 관련 자료를 활용하였으며, 각 자료의 명칭과 출처는 Table 1과 Table 2에 제시하였다.
|
No. |
Accident cause analysis method |
Source |
|
1 |
SHELL (Software, Hardware,
Environment, Liveware, Liveware Model) |
FAA (2000) |
|
2 |
HFACS (Human Factors Analysis and
Classification System) |
Shappell et al. (2006) |
|
3 |
GEMS (Generic Error-Modelling
System) |
HSE (1999) |
|
4 |
CREAM (Cognitive Reliability and
Error Analysis Method) |
NASA (2011) |
|
5 |
TEM (Threat and Error Management) |
FAA (2006) |
|
6 |
HEART (Human Error Assessment and
Reduction Technique) |
Bell and Holroyd (2009) |
|
7 |
HERCA (Human Error Root Cause
Analysis) |
Tomić et al. (2022) |
|
8 |
SPAR-H (Standardized Plant Analysis
Risk–Human Reliability Analysis) |
Gertman et al. (2005) |
|
9 |
PEAR (People, Environment, Actions,
Resources) |
Johnson and Maddox (2007) |
|
10 |
AcciMap (Accident Mapping) |
Rasmussen and Svedung (2000) |
|
11 |
TapRooT (TapRooT Root Cause
Analysis System) |
Paradies and Carr (2023) |
|
12 |
STAMP (Systems-Theoretic Accident
Model and Processes) |
Leveson (2004) |
|
13 |
FTA (Fault Tree Analysis) |
Vesely et al. (1981) |
|
14 |
FMEA (Failure Mode and Effects
Analysis) |
Grout (2007) |
|
15 |
Bowtie (Bowtie Analysis) |
CAA
(2020) |
|
16 |
FSD (Failure Sequence Diagram) |
Raspotnig
and Opdahl (2012) |
|
17 |
MORT (Management Oversight and Risk Tree) |
Knox and
Eicher (1992) |
|
18 |
CCA (Cause-Consequence Analysis) |
Nielsen
(1974) |
|
19 |
FRAM (Functional Resonance Analysis Method) |
Hollnagel
et al. (2014) |
|
20 |
SRCA (Safety Requirements/Criteria Analysis) |
DoD
(1993) |
|
21 |
RMF (Rasmussen's Risk
Management Framework) |
Rasmussen
(1997) |
|
22 |
Swiss Cheese Model (Reason's Swiss Cheese
Model) |
Reason
(2000) |
|
23 |
RCA (Root Cause Analysis) |
DOE
(1992) |
|
24 |
Tripod Beta (Tripod Beta) |
STF
(2015) |
|
25 |
ETA (Event Tree Analysis) |
NASA
(2011) |
|
26 |
CAST (Causal Analysis based on System Theory) |
Düzgün
and Leveson (2018) |
|
No. |
Documents containing checklists |
Source |
|
1 |
Employee accident investigation |
SHRM (2023) |
|
2 |
Injury report/accident investigation checklist |
SafetyPro Resources |
|
3 |
Accident investigation report |
Farm Safety Association
(2026) |
|
4 |
Incident [Accident] investigations: A guide for employers |
OSHA (2015) |
|
5 |
Possible accident investigation questions |
Minnesota DOA (2026) |
|
6 |
Guidelines for preventing human error in process safety |
CCPS (1994) |
|
7 |
Human factors for SMEs |
Guildford Ergonomics
(2016) |
|
8 |
Human factors in the management of major accident hazards |
HSE (2005) |
|
9 |
Revalidating process hazard analyses |
Frank and Whittle (2001) |
|
10 |
Tips for investigating workplace incidents |
WHS Queensland (2016) |
각 사고원인 분석기법은 고유한 분석 절차와 체계가 존재하지만, 이를 고려하지 않고 공통적으로 활용될 수 있는 사고원인 항목을 중심으로 텍스트 형태의 데이터로 수집하였다. 사고원인 분석기법을 통해 도출된 단어형 데이터와 체크리스트를 통해 도출된 문장형 데이터 중에서 사고원인에 해당하지 않는다고 판단되는 단어 및 문장을 제거하였다. 또한 체크리스트에서 도출된 문장형 데이터는 동일한 사고원인이라도 다양한 표현 방식으로 기술될 수 있다는 점을 고려하여 문장형 데이터에서 표현되는 핵심 단어를 선별하여 단어형 데이터로 변환하는 과정을 거쳤으며, 중복되는 요소를 제거하여 최종 분석 단위를 단어형 데이터로 변환하였다. 최종적으로 BERTopic 모델링은 영문으로 구성된 단어형 사고원인 데이터를 기반으로 수행하였다.
이와 같이 최종 분석 단위를 단어형 데이터로 통일한 것은 서로 다른 사고원인 분석기법과 체크리스트에서 다양한 형태로 제시된 사고원인 항목을 일관된 기준으로 분석하기 위함이다. 본 연구는 문서 단위에서 주제를 탐색하는 것보다, 수집된 사고원인 항목 간의 의미적 유사성을 파악하여 유사한 항목을 군집화하고 이를 체계적으로 구조화하는 데 목적이 있다. BERTopic은 Transformer 기반 임베딩을 통해 텍스트의 의미적 특성을 벡터로 표현하고, 의미적으로 유사한 항목을 군집화할 수 있다는 특징을 가진다. 따라서 문맥 정보가 제한적인 단어형 데이터라도 각 사고원인 항목의 의미적 유사성을 벡터 공간에서 비교하고 군집화하는 데 활용할 수 있다. 이에 본 연구에서는 이러한 특성을 활용하여 단어형 사고원인 항목 간의 의미적 유사성을 분석하고 사고원인 분류체계를 구축하고자 하였다.
2.3 Performance comparison for optimal BERTopic modeling
본 과정에서는 사고원인 분류체계 도출에 적합한 BERTopic 모델을 구성하기 위해 관련 선행연구를 검토하였다. 임베딩 모델은 모델의 성능, 선행연구에서의 활용도 및 텍스트의 의미적 특성을 표현하는 능력 등을 고려하여 3개를 선정하였다. 또한 BERTopic 결과의 해석 가능성과 군집 구조에 영향을 미치는 주요 요소를 중심으로 3개의 파라미터를 선정하였으며, 모델링 결과를 객관적으로 비교하기 위해 2개의 평가지표를 선정하였다. 이를 바탕으로 다양한 모델 조합을 설정하고, 선정된 평가지표를 기반으로 각 조합의 성능을 비교하였다. 각 조합의 성능은 2개 평가지표의 합, 평가지표별 평균의 합, 각 평가지표 간 최댓값 차이, 2개 평가지표 전체 값의 평균을 기준으로 비교하였다. 이를 통해 도출된 최적 조합을 사고원인 분류체계 도출 과정에 활용하였다.
최종적으로 선정된 임베딩 모델 후보는 MiniLM 계열의 all-MiniLM-L6-v2, paraphrase-MiniLM-L6-v2와 범용 임베딩 모델의 all-mpnet-base-v2이었다. 이들은 모두 사전에 학습된 Sentence-Transformers 계열의 임베딩 모델로, 텍스트의 의미 정보를 벡터 공간에 표현하여 텍스트 항목 간 의미적 유사성을 효과적으로 반영할 수 있는 강점을 지니고 있다. 본 연구에서는 서로 다른 사전학습 임베딩 모델의 성능을 비교하고 사고원인 데이터에 보다 적합한 모델을 선정하기 위해 이들 3개 모델을 비교 대상으로 선정하였다. 또한 BERTopic 모델링 결과에 영향을 미치는 주요 파라미터로 n_gram_range, top_n_words, min_topic_size를 선정하였다. 이들은 모두 BERTopic 모델링 결과의 품질과 해석 가능성에 영향을 미치는 주요 요소이다. n_gram_range는 토픽을 구성하는 단어 조합의 범위를 설정하는 파라미터이며, top_n_words는 각 토픽을 설명하는 상위(대표) 단어의 수를 결정한다. min_topic_size는 하나의 토픽을 형성하기 위한 최소 데이터 수를 조정하는 파라미터로, 도출되는 토픽의 수와 군집의 세분화 정도에 영향을 줄 수 있다. 따라서 본 연구에서는 토픽의 해석과 군집의 구성에 직접적인 영향을 미치는 이들 3개 파라미터를 주요 비교 대상으로 선정하였다. n_gram_range는 최대 3개의 단어 조합까지 고려할 수 있도록 (1, 1)부터 (2, 3)까지의 범위를 설정하였으며, top_n_words와 min_topic_size는 각각 최소 5개부터 최대 30개까지의 범위를 설정하였다. 마지막으로 BERTopic 모델링 결과의 타당성을 객관적으로 검토할 수 있는 평가지표로 Topic Diversity와 Coherence Value (C_V)를 활용하였다. Topic Diversity는 도출된 토픽 간 판별성을 평가하는 지표이며, C_V는 토픽을 구성하는 단어 간의 의미적 일관성을 평가하는 지표이다. 두 평가지표는 토픽 간의 분리 정도와 토픽 내의 응집성을 각각 평가함으로써, BERTopic 모델링 결과의 품질을 단일 기준이 아닌 복합적인 관점에서 검토하는 데 활용되었다.
2.4 Topic labeling
최적의 조합을 적용한 BERTopic 모델링 결과를 바탕으로 도출된 각 군집의 주요 단어를 검토하고, 각 군집의 의미를 해석하여 1차 토픽명을 설정했다. 1차 토픽명은 군집을 구성하는 주요 단어 간의 의미적 일관성과 군집 간의 구분 가능성을 종합적으로 고려하여 도출하였다. 이후 각 군집의 규모와 군집 내 항목의 의미적 구성을 검토한 결과, 50개 이상의 단어가 포함된 군집은 하나의 토픽으로 설명하기에 범위가 넓고 서로 다른 의미의 항목이 함께 포함되어 있는 것으로 판단하였다. 이에 본 연구에서는 50개 이상의 단어가 포함된 군집을 추가적인 세분화가 필요한 군집으로 설정하고 BERTopic 모델링을 다시 수행하였다. 그러나 이러한 반복 과정이 수행된 이후에도 군집 간 의미적 중복성, 군집 내 이질성 및 의미 수준 불균형이 지속적으로 나타나는 군집은 연구진의 정성적 판단에 따라 별도로 재군집화하는 단계를 거쳤다.
3.1 Data collection results
본 연구에서는 26개의 사고원인 분석기법을 통해 단어형 데이터 282건과 10개의 체크리스트를 통해 문장형 데이터 389건을 수집하였다. 도출된 671건의 단어 및 문장형 데이터 중 사고원인에 해당하지 않는 불명확한 단어 및 문장형 데이터 274건을 선별하여 제거하였다. 제거 후 남은 397건의 단어 및 문장형 데이터 중 문장형 데이터는 일관성 있는 분류를 위해 문장에서 표현된 여러 핵심 단어를 선별하여 단어형 데이터로 변환하였다. 변환된 단어형 데이터와 기존에 도출된 단어형 데이터를 통합하고 중복 요소를 제거하여 최종적으로 총 630개의 단어형 데이터 셋을 구축했다.
3.2 Results of performance comparison for optimal BERTopic modeling
Table 3은 임베딩 모델별 전체 파라미터 조합에 대한 두 평가지표의 합산값을 비교한 결과이다. 임베딩 모델 paraphrase-MiniLM-L6-v2의 (1, 1)/20/15 조합에서 Topic Diversity와 C_V의 합산값은 1.780으로 제일 높게 나타났다. 반면, all-MiniLM-L6-v2의 (1, 1)/25/15 조합과 all-mpnet-base-v2의 (2, 3)/30/15 조합의 합산값은 모두 1.725로 paraphrase-MiniLM-L6-v2에 비해 상대적으로 낮게 나타났다(Table 3).
|
Item |
all-MiniLM-L6-v2 |
paraphrase-MiniLM-L6-v2 |
all-mpnet-base-v2 |
|
n_gram_range |
(1, 1) |
(1, 1) |
(2, 3) |
|
top_n_words |
25 |
20 |
30 |
|
min_topic_size |
15 |
15 |
15 |
|
Topic Diversity |
0.854 |
0.987 |
0.878 |
|
C_V |
0.871 |
0.793 |
0.847 |
|
Sum |
1.725 |
1.780 |
1.725 |
Table 4는 임베딩 모델별 전체 파라미터 조합에 대한 각 평가지표 평균의 합산값을 비교한 결과이다. Topic Diversity 평균값은 paraphrase-MiniLM-L6-v2가 0.877로 제일 높게 나타났고, all-MiniLM-L6-v2과 all-mpnet-base-v2가 0.875로 상대적으로 낮게 나타났다. 반면 C_V 평균값은 all-mpnet-base-v2가 0.759로 제일 높게 나타났고, paraphrase-MiniLM-L6-v2가 0.747로 상대적으로 낮게 나타났다. 아울러 각 평가지표의 평균값을 합산한 결과 all-mpnet-base-v2가 1.634으로 가장 높게 나타났으며, all-MiniLM-L6-v2와 paraphrase-MiniLM-L6-v2는 1.625와 1.624로 상대적으로 낮게 나타났다(Table 4).
|
Item |
Mean of topic diversity |
Mean of C_V |
Sum of mean metric values |
|
all-MiniLM-L6-v2 |
0.875 |
0.750 |
1.625 |
|
paraphrase-MiniLM-L6-v2 |
0.877 |
0.747 |
1.624 |
|
all-mpnet-base-v2 |
0.875 |
0.759 |
1.634 |
임베딩 모델별 전체 파라미터 조합 중 각 평가지표가 최댓값을 보이는 조합을 선정하고, 해당 조합에서 다른 평가지표와의 차이를 비교했다(Table 5). all-MiniLM-L6-v2의 전체 파라미터 조합에 대한 Topic Diversity의 최댓값은 0.922로 (1, 2)/20/10의 조합에서 나타났으며, C_V의 값은 0.781로 나타났다. C_V의 최댓값은 0.871로 (1, 1)/25/15의 조합에서 나타났으며, Topic Diversity의 값은 0.854로 나타났다. paraphrase-MiniLM-L6-v2의 경우 Topic Diversity의 최댓값은 0.987로 (1, 1)/20/15의 조합에서 나타났으며, C_V의 값은 0.793으로 나타났다. C_V의 최댓값은 0.854로 (2, 2)/25/15의 조합에서 나타났으며, Topic Diversity의 값은 0.872로 나타났다. all-mpnet-base-v2에서는 Topic Diversity의 최댓값이 0.990으로 (1, 1)/30/30의 조합에서 나타났으며, C_V의 값은 0.695로 나타났다. C_V의 최댓값은 0.847로 (2, 3)/30/15의 조합에서 나타났으며, Topic Diversity의 값은 0.878로 나타났다. 선정된 각 조합의 두 평가지표 간의 차이를 계산한 결과, all-MiniLM-L6-v2의 (1, 1)/25/15 조합에서 그 차이값이 0.017로 제일 작게 나타났다. 반대로, 가장 큰 차이값은 0.295로 all-mpnet-base-v2의 (1, 1)/30/30 조합에서 나타났다(Table 5).
|
Item |
all-MiniLM-L6-v2 |
paraphrase-MiniLM-L6-v2 |
all-mpnet-base-v2 |
|||
|
n_gram_range |
(1, 1) |
(1, 2) |
(2, 2) |
(1, 1) |
(2, 3) |
(1, 1) |
|
top_n_words |
25 |
20 |
25 |
20 |
30 |
30 |
|
min_topic_size |
15 |
10 |
15 |
15 |
15 |
30 |
|
Topic Diversity |
0.854 |
0.922 |
0.872 |
0.987 |
0.878 |
0.990 |
|
C_V |
0.871 |
0.781 |
0.854 |
0.793 |
0.847 |
0.695 |
|
Difference |
0.017 |
0.141 |
0.018 |
0.194 |
0.031 |
0.295 |
Table 6은 임베딩 모델별 전체 파라미터 조합에 대한 두 평가지표의 평균값을 비교한 결과이다. Topic Diversity와 C_V의 평균값이 가장 큰 임베딩 모델은 all-mpnet-base-v2로 나타났으며, 평균값은 0.817로 나타났다. all-MiniLM-L6-v2과 paraphrase-MiniLM-L6-v2의 평균값은 각각 0.813, 0.812로 all-mpnet-base-v2보다 상대적으로 낮게 나타났다(Table 6).
|
Item |
Mean metric values across all
combinations |
|
all-MiniLM-L6-v2 |
0.813 |
|
paraphrase-MiniLM-L6-v2 |
0.812 |
|
all-mpnet-base-v2 |
0.817 |
총 4가지의 기준을 통해 모델의 성능을 비교 분석한 결과, 사고원인 분류체계 도출을 위한 최적의 BERTopic 모델링 조합은 all-mpnet-base-v2의 (1, 1)/25/15으로 도출되었다. 특히 all-mpnet-base-v2은 총 4가지의 기준 중 2가지의 기준에서 가장 좋은 성능을 나타났으며, 그 중 (1, 1)/25/15의 조합은 Topic Diversity 값이 0.878, C_V값이 0.847로 다른 조합에 비해 상대적으로 우수한 성능을 나타났다(Table 7).
|
Model |
Parameter |
Evaluation metrics |
|||
|
all-mpnet-base-v2 |
n_gram_range |
top_n_words |
min_topic_size |
Topic diversity |
C_V |
|
(1, 1) |
25 |
15 |
0.878 |
0.847 |
|
3.3 Topic labeling results
3.2에서 도출된 최적의 조합을 기반으로 BERTopic 모델링을 수행한 결과, 총 9개의 군집이 도출되었다. 각 군집을 구성하고 있는 주요 단어를 해석하여 1차 토픽 라벨링을 수행하였다. 군집 0은 behavior, conduct, listening 등의 단어로 구성되었으며, 이를 근로자의 작업 시 태도 및 의사소통과 관련된 토픽으로 설정했다. 군집 1은 barriers, control, design 등의 단어로 구성되었으며, 이를 작업 수행 조건 및 시스템 제약 요인과 관련된 토픽으로 설정했다. 군집 2는 boredom, distraction, isolation 등의 단어로 구성되었으며, 이를 근로자의 정신 상태와 관련된 토픽으로 설정했다. 군집 3은 identifiable, distinguishable, term 등의 단어로 구성되었으며, 이를 근로자의 인지적 오류와 관련된 토픽으로 설정했다. 군집 4는 company, budget, inadequate 등의 단어로 구성되었으며, 이를 조직관리 및 작업환경 요인과 관련된 토픽으로 설정했다. 군집 5는 adjustment, rotation, revisions 등의 단어로 구성되었으며, 이를 근로자의 근무 일정 및 작업 적응 요인과 관련된 토픽으로 설정했다. 군집 6은 defective, hardware, mechanism 등의 단어로 구성되었으며, 이를 물리적 설비 및 시스템 결함과 관련된 토픽으로 설정했다. 군집 7은 rules, procedure, operating 등의 단어로 구성되었으며, 이를 작업 절차 및 작업 수행 방식과 관련된 토픽으로 설정했다. 마지막으로, 군집 8은 maintain, allocation, provision 등의 단어로 구성되었으며, 이를 자원 관리 및 유지보수와 관련된 토픽으로 설정했다(Table 8).
|
Cluster |
Keywords |
Topic labeling |
|
0 |
Behavior, communication, conduct, interactions, language,
listening, manner, response, interpersonal, involve |
Worker attitude and communication |
|
1 |
Barriers, bugs, compatibility, conflicting, control, delayed, |
Work conditions and system constraints |
|
2 |
Boredom, concentration, distraction, fatigue, inattentiveness,
mental, isolation, nuisance, complacency, cognitive |
Worker mental state |
|
3 |
Identifiable, immediate, distinguishable, legibly, monotonous,
recognize, routine, similar, term, unusual |
Worker cognitive errors |
|
4 |
Company, conditions, budget, employees, design, funding,
inadequate, leadership, management, monitoring |
Organizational management and |
|
5 |
Adjustment, breaks, rotation, shift, turnaround, revisions, |
Work schedule and adaptation |
|
6 |
Defective, equipment, hardware, machine, mechanism, technological,
tools, components, instrument, machinery |
Physical equipment and system defects |
|
7 |
Rules, steps, work, process, procedures, procedure, phases,
operating, method, execution |
Work procedures and methods |
|
8 |
Maintain, provided, support, keeping, allocation, available,
eliminated, minimized, provision, maintaining |
Resource maintenance and management |
총 9개의 군집 중 군집 1, 군집 3, 군집 4는 50개 이상의 단어를 포함하고 있어, 각 군집의 단어를 포괄적으로 설명할 수 있는 토픽을 설정하는 데 한계가 있다고 판단하였다. 따라서 군집 내 단어를 세분화하여 각 군집의 의미를 보다 명확하게 설명할 수 있는 토픽을 설정하기 위해 해당 군집에 대해서는 앞서 설명한 동일한 절차에 따라 재군집화를 수행하였다.
그 결과, 군집 1은 4개의 군집으로, 군집 3은 5개의 군집으로, 군집 4는 3개의 군집으로 구분되었다. 군집 1의 하위 군집 0은 verification, probability 등의 단어로 구성되었으며, 이를 작업자의 정보 판단 및 인식의 정확성과 관련된 하위 토픽으로 설정하였다. 하위 군집 1은 regulations, guidelines 등의 단어로 구성되었으며, 이를 제도 및 정책 요인과 관련된 하위 토픽으로 설정하였다. 하위 군집 2는 bugs, compatibility 등의 단어로 구성되었으며, 이를 기술 및 시스템 기반의 문제와 관련된 하위 토픽으로 설정하였다. 마지막으로, 하위 군집 3은 operational, monitoring 등의 단어로 구성되었으며, 이를 운영 및 조직과 관련된 하위 토픽으로 설정하였다.
군집 3에 포함된 하위 군집 0은 social, resources 등의 단어로 구성되었으며, 이를 조직 환경 및 제도적 조건과 관련된 하위 토픽으로 설정하였다. 하위 군집 1은 unsafe, shortage 등의 단어로 구성되었으며, 이를 작업현장의 위험요인 및 설비 결함 조건과 관련된 하위 토픽으로 설정하였다. 하위 군집 2는 training, coordination 등의 단어로 구성되었으며, 이를 교육 및 작업자의 역량 미흡과 관련된 하위 토픽으로 설정하였다. 하위 군집 3은 noise, materials 등의 단어로 구성되었으며, 이를 물리적 작업환경 요인과 관련된 하위 토픽으로 설정하였다. 마지막으로, 하위 군집 4는 workers, supervisors 등의 단어로 구성되었으며, 이를 작업 구조 및 작업자 간 역할 배분과 관련된 하위 토픽으로 설정하였다.
군집 4에 포함된 하위 군집 0은 specifically, separate 등의 단어로 구성되었으며, 이를 정보의 명확성과 혼란에 관련된 하위 토픽으로 설정하였다. 하위 군집 1은 routine, standard 등의 단어로 구성되었으며, 이를 작업 조건의 표준화와 예외적 작업과 관련된 하위 토픽으로 설정했다. 마지막으로, 하위 군집 2는 visible, recognize 등의 단어로 구성되었으며, 이를 외부 자극에 기반한 작업자 인식과 관련된 하위 토픽으로 설정하였다(Table 9).
Cluster number |
Sub-cluster number |
Keywords |
Topic labeling |
|
1 |
0 |
Verification,
reasoning, probability, |
Accuracy of worker information judgement and perception |
|
1 |
Regulations, policies, guidelines, laws, rules |
Institutional and policy factors |
|
|
2 |
Bugs, error, conflicting, compatibility, faulty, substitutes |
Technology and system-based issues |
|
|
3 |
Operational, assessment, monitoring, culture, decision |
Operational and organizational factors |
|
|
3 |
0 |
Social, situational,
resources, procedural, quality |
Organizational environment
and |
|
1 |
Unsafe, failures,
shortage, substandard, risk |
Worksite hazards and equipment |
|
|
2 |
Training, skills,
coordination, competence, |
Training and worker competency |
|
|
3 |
Noise, lighting, materials, influences, factors |
Physical work environment factors |
|
|
4 |
Workers, teams, supervisors, work, allocation |
Work structure and worker role allocation |
|
|
4 |
0 |
Specifically, similar, separate, properly, familiar |
Information clarity and confusion |
|
1 |
Routine, repetitive,
standard, strenuous, special |
Standardized working conditions and |
|
|
2 |
Visible, signs, recognize, observation, sense |
Worker perception of external stimuli |
앞서 수행된 BERTopic 모델링 과정을 통해 도출된 결과를 바탕으로, 군집 간 의미적 중복성, 군집 내 이질성 및 의미 수준 불균형이 지속적으로 나타나는 군집은 연구진(3인)의 정성적 판단에 따라 별도로 군집 간 통합 및 구조 정비 과정을 통해 최종적으로 사고원인 분류체계를 구축했다.
3.4 Development of the final accident cause taxonomy
최종적으로 총 5개의 상위 요인, 17개의 하위 요인, 그리고 27개의 세부 요인으로 분류체계를 구축하였다. 5개의 상위 요인에는 '작업자 요인(Worker Factors)', '조직 요인(Organizational Factors)', '물리적 시스템 요인(Physical System Factors)', '운영시스템 요인(Operational System Factors)', '환경 요인(Environmental Factors)'으로 구성되었다.
상위 요인 1의 '작업자 요인'은 5개의 하위 요인으로 구성되었으며, 이는 '불안전한 작업자 상태 요인', '의도적 규정 위반 요인', '작업자 간 의사소통 요인', '감각 기반 요인', '지식 기반 요인'으로 구분되었다. 하위 요인 1의 '불안전한 작업자 상태 요인'은 2개의 세부 요인으로 구성되었으며, 이는 '정신적 상태 요인', '신체적 상태 요인'으로 구분되었다. 하위 요인 4의 '감각 기반 요인'은 2개의 세부 요인으로 구성되었으며, 이는 '작업 변화 부적응 요인', '익숙함에 의한 요인'으로 구분되었다. 하위 요인 5의 '지식 기반 요인'의 경우 4개의 세부 요인으로 구성되었으며, 이는 '경험 기반 판단 요인', '비숙련 판단 요인', '작업 절차 요인', '작업 방법 요인'으로 구분되었다. 즉, 상위 요인 1의 '작업자 요인'은 작업자의 신체적 · 정신적 상태, 지식과 경험 수준, 행동 특성, 작업 수행 방식 등 작업자 개인의 특성과 행위에 기인하는 요인을 모두 포함하였다(Table 10).
|
Main factor |
Sub-factor |
Detailed factor |
|
Worker factors |
Unsafe worker condition factors |
Mental state factors |
|
Physical state factors |
||
|
Intentional rule violation factors |
- |
|
|
Inter-worker communication factors |
- |
|
|
Sensory-based factors |
Maladaptation to work changes |
|
|
Familiarity-based factors |
||
|
Knowledge-based factors |
Experience-based judgement factors |
|
|
Inexperience-based judgement factors |
||
|
Work procedure factors |
||
|
Work method factors |
상위 요인 2의 '조직 요인'은 3개의 하위 요인으로 구성되었으며, 이는 '조직 구조 요인', '자원 부족 요인', '인적 자원 관리 요인'으로 구분되었다. 하위 요인 1의 '조직 구조 요인'은 5개의 세부 요인으로 구성되었으며, 이는 '조직 구조 결함 요인', '팀 구성 결함 요인', '인력 구성 불균형 요인', '채용 · 선발 체계 미비 요인', '감독 · 관리 체계 미비 요인'으로 구분되었다. 하위 요인 2의 '자원 부족 요인'은 3개의 세부 요인으로 구성되었으며, 이는 '자재 · 물자 부족 요인', '예산 부족 요인', '자원의 일시적인 사용 불가 요인'으로 구분되었다. 하위 요인 3의 '인적 자원 관리 요인'의 경우 5개의 세부 요인으로 구성되었으며, 이는 '인력 계획 · 조직 미비 요인', '자격 기반 선발 미흡 요인', '교육 · 훈련 부족 요인', '성과 관리 미흡 요인', '행동 · 규율 관리 미흡 요인'으로 구분되었다. 즉, 상위 요인 2의 '조직 요인'은 산업재해 발생에 영향을 미치는 조직의 구조, 관리체계, 자원 배분 및 운영상의 문제와 관련된 요인을 모두 포함한다(Table 11).
|
Main factor |
Sub-factor |
Detailed factor |
|
Organizational factors |
Organizational structure factors |
Organizational structure defects |
|
Team composition defects |
||
|
Workforce composition imbalance |
||
|
Inadequate recruitment and selection system |
||
|
Inadequate supervision and management system |
||
|
Resource shortage factors |
Material and supply shortages |
|
|
Budget shortages |
||
|
Temporary unavailability of resources |
||
|
Human resource management factors |
Inadequate workforce planning and organization |
|
|
Inadequate qualification-based selection |
||
|
Insufficient education and training |
||
|
Inadequate performance management |
||
|
Inadequate behavior and discipline management |
상위 요인 3의 '물리적 시스템 요인'은 3개의 하위 요인으로 구성되었으며, 이는 '물리적 구성요소 결함 요인', '기능 · 성능 결함 요인', '설계 · 기술적 부적합 요인'으로 구분되었다. 즉, 상위 요인 3의 '물리적 시스템 요인'은 산업현장에서 사용되는 설비, 장비, 부품 등 물리적 구성요소의 결함이나 기술적 부적합으로 인해 사고 발생에 영향을 미치는 요인을 모두 포함한다(Table 12).
|
Main factor |
Sub-factor |
Detailed factor |
|
Physical system factors |
Physical component defect factors |
- |
|
Functional and performance defect factors |
- |
|
|
Design and technical unsuitability factors |
- |
상위 요인 4의 '운영시스템 요인'은 4개의 하위 요인으로 구성되었으며, 이는 '정책 · 규제 요인', '시스템 요인', '운영상 체계 결함 요인', '작업 절차 및 방식 정의 부족 요인'으로 구분되었다. 하위 요인 1의 '정책 · 규제 요인'은 2개의 세부 요인으로 구성되었으며, 이는 '정책 · 규제 부재 요인', '정책 · 규제 미흡 요인'으로 구분되었다. 하위 요인 2의 '시스템 요인'은 2개의 세부 요인으로 구성되었으며, 이는 '시스템 오류 요인', '시스템 부적합 요인'으로 구분되었다. 하위 요인 3의 '운영상 체계 결함 요인'의 경우 2개의 세부 요인으로 구성되었으며, 이는 '사후 조치 미흡 요인', '운영상 기록 · 분석 · 평가 · 체계 미흡 요인'으로 구분되었다. 즉, 상위 요인 4의 '운영시스템 요인'은 정책 수립, 시스템 설계, 작업 절차 및 방식의 정의, 정보 관리 체계 등 산업현장의 운영과 관리 시스템 전반에서 발생하는 요인을 모두 포함한다(Table 13).
|
Main factor |
Sub-factor |
Detailed factor |
|
Operational system factors |
Policy and regulatory factors |
Absence of policies and regulations |
|
Inadequate policies and regulations |
||
|
System factors |
System errors |
|
|
System unsuitability |
||
|
Operational system failure factors |
Inadequate follow-up actions |
|
|
Inadequate system for operational |
||
|
Insufficient definition of work procedures and methods |
- |
상위 요인 5의 '환경 요인'은 2개의 하위 요인으로 구성되었으며, 이는 '작업 환경 요인', '물리적 환경 요인'으로 구분되었다. 즉, 상위 요인 5의 '환경 요인'은 작업자가 수행하는 작업을 둘러싼 물리적, 기상적, 공간적 환경 조건으로 인해 사고 발생 가능성이 높아지는 요인을 모두 포함한다(Table 14).
|
Main factor |
Sub-factor |
Detailed factor |
|
Environmental factors |
Work environment factors |
- |
|
Physical environment factors |
- |
본 연구는 사고원인을 보다 객관적이고 체계적으로 수집하기 위한 BERTopic 기법을 활용한 사고원인 분류체계화 방법론 및 체계화를 제안하였다. 이를 위해 다양한 사고원인 분석기법과 현장에서 활용되는 체크리스트를 토대로 데이터를 수집하였으며, 다양한 임베딩 모델과 주요 파라미터 조합을 적용하여 평가지표 기반의 BERTopic 모델링 성능 비교를 수행했다. 이를 바탕으로 최적의 BERTopic 모델링 조건을 선정하고, 도출된 군집에 대해 의미적 해석을 수행하여 1차 토픽을 설정하였다. 더불어, 규모가 큰 군집을 중심으로 재군집화를 수행하여 토픽을 세부적으로 구조화하였으며, 이후에도 의미적 구분이 명확하지 않은 군집은 연구진 3인의 정성적 검토를 통해 재구조화를 수행하였다. 최종적으로 상위 요인, 하위 요인, 세부 요인으로 구성된 3단계 사고원인 분류체계를 제안하였다.
본 연구에서 도출된 사고원인 분류체계의 세분화 수준을 살펴보면, '작업자 요인'은 5개의 하위 요인과 8개의 세부 요인, '조직 요인'은 3개의 하위 요인과 13개의 세부 요인, '운영시스템 요인'은 4개의 하위 요인과 6개의 세부 요인으로 구성되었다. 반면 '물리적 시스템 요인'은 3개의 하위 요인, '환경 요인'은 2개의 하위 요인으로 구성되었으며 별도의 세부 요인은 도출되지 않았다. 이러한 경향은 기존 사고원인 분석기법의 분석 관점과 비교하여 살펴볼 수 있다. HFACS는 작업자, 감독 및 조직 관련 요인을 상대적으로 세분화하여 다루고 있으며(Shappell and Wiegmann, 2000), AcciMap은 물리적 · 환경적 요인을 포함한 다양한 사회기술시스템 수준 간의 상호작용을 중심으로 사고를 분석한다(Rasmussen, 1997; Svedung and Rasmussen, 2002). 또한 STAMP는 시스템 내 통제 및 피드백 관계를 중심으로 사고 발생 과정을 설명한다(Leveson, 2004; Düzgün and Leveson, 2018). 이러한 기존 사고원인 분석기법의 특성과 비교할 때, 본 연구에서도 '작업자 요인', '조직 요인', '운영시스템 요인'은 상대적으로 세분화된 반면, '물리적 시스템 요인'과 '환경 요인'은 비교적 덜 세분화되는 유사한 경향이 나타난 것으로 볼 수 있다.
이러한 결과는 실제 사고원인의 중요도 차이를 직접적으로 의미하기보다는, 본 연구에서 수집한 사고원인 분석기법 및 체크리스트가 중점적으로 탐색하도록 구성된 요인 영역이 도출된 분류체계의 세분화 수준에 영향을 미쳤을 가능성을 시사한다. 이는 분석 과정에서 도출되는 사고원인 범주가 활용된 사고모형 및 조사도구의 분석 관점에 영향을 받을 수 있다는 Lundberg et al. (2009)의 WYLFIWYF (What-You-Look-For-Is-What-You-Find) 원칙과 연결된다. 이러한 관점에서 본 연구에 활용된 사고원인 분석기법과 체크리스트가 물리적 시스템 및 환경과 관련된 요인보다 작업자, 조직, 운영시스템과 관련된 요인을 상대적으로 구체적이고 세밀하게 다루고 있었을 가능성이 있다고 판단된다.
더불어, '작업자 요인' 뿐만 아니라 '조직 요인', '운영시스템 요인'이 상대적으로 세분화된 수준까지 구분된 것은 Reason (1990)의 관점과 관련하여 해석할 수 있다. Reason (1990)에서는 사고가 작업자, 조종사, 운전원 등과 같이 사고와 밀접한 위치에 있는 사람으로부터 발생하는 즉각적인 오류인 Active failure와, 사고가 발생하기 훨씬 전부터 조직 안에 잠재되어 있던 관리체계, 절차, 감독, 의사소통 등의 latent failure의 결합으로 발생할 수 있다고 설명했다. 이러한 관점에서 본 연구에서 도출된 '조직 요인'과 '운영시스템 요인'이 '작업자 요인'과 함께 세분화되어 분류된 것은 기존에 활용되고 있는 사고원인 분석기법이 사람의 직접적 행위뿐 아니라, 그 행위를 유발하는 잠재적인 조직 · 관리 조건을 중요한 요인으로서 바라보며 이를 세밀하게 다루고 있을 가능성을 시사한다.
반면, '물리적 시스템 요인'과 '환경 요인'은 비교적 덜 세분화되는 양상을 보였다는 점은 본 연구에서 실제로 활용된 기존의 사고원인 분석기법의 관점과 관련하여 해석할 수 있다. HFACS는 사고 요인을 크게 불안전한 행동, 불안전한 행동의 전제조건, 불안전한 감독, 조직적 영향의 4가지 수준으로 구분하며, 작업자의 상태, 감독 미흡, 부적절한 작업계획, 자원 관리 등의 인간 및 조직 중심의 요인을 세부적으로 제시했다(Shappell and Wiegmann, 2000). 이와 같은 맥락으로, AcciMap과 STAMP 또한 사고 발생을 특정 설비의 결함이나 개별 요인의 직접적인 결과로 설명하기보다, 사회기술시스템 내 개인, 현장, 조직, 관리, 규제 등 다양한 수준의 상호작용, 통제, 피드백의 결과로 설명하고 있다(Rasmussen, 1997; Svedung and Rasmussen, 2002; Leveson, 2004; Düzgün and Leveson, 2018). 따라서 '물리적 시스템 요인' 및 '환경 요인'은 독립적인 세부 범주 요인으로서 구분되기보다 작업자 행동, 조직관리, 운영 절차, 통제 구조 등 다른 요인들과의 관계 속에서 포괄적으로 다루어졌을 가능성이 있다. 이러한 점을 고려했을 때 본 연구에서 '작업자 요인', '조직 요인', '운영시스템 요인'이 상대적으로 세부적으로 구분된 반면, '물리적 시스템 요인'과 '환경 요인'이 비교적 덜 세분화된 것은 기존 사고원인 분석기법들이 인간, 감독, 조직 및 운영관리 측면에 초점을 두고 분석해 온 분석 관점이 반영된 결과임을 추론할 수 있다.
본 연구는 BERTopic 모델의 성능이 임베딩 모델, 주요 파라미터, 평가지표 등의 분석 조건에 따라 달라질 수 있음을 고려하여, 다양한 조합을 설정하고 성능을 비교하여 분석했다는 점에서 의의가 있다. 특히, 널리 활용되고 있는 임베딩 모델, 주요 파라미터, 평가지표를 선행연구 고찰을 통해 종합적으로 검토함으로써 사고원인 분류체계 구축에 적합한 최적의 모델링 조건을 도출하고자 하였다. 또한 BERTopic 기법을 통해 사고원인 항목을 정량적으로 분석 및 분류하고 이를 전문가의 정성적 검토를 통해 체계화했다는 점에서 의미가 있다. 즉, 데이터 기반의 정량적 분석과 전문가 기반의 정성적 해석을 상호보완적으로 활용하여 사고원인 분류체계의 활용 및 해석 가능성을 높이고자 했다. 더불어, 이를 통해 도출된 사고원인 분류체계는 사고원인을 구조화된 기준에 따라 분류할 수 있도록 지원함으로써, 분석자의 경험 및 역량 차이로 발생할 수 있는 해석의 편차를 줄이고 다양한 현장과 환경에서 보다 일관된 사고원인 분석을 수행하는 데 기여할 수 있다는 점에서 의미가 있다.
그러나 본 연구는 다음과 같은 한계를 지닌다. 첫째, 수집된 데이터의 규모와 범위가 제한적이기 때문에 모든 사고원인 항목을 포괄적으로 반영하는 데 한계가 있다. 둘째, BERTopic은 문맥 정보를 포함한 텍스트 데이터의 의미적 관계를 분석하는 데 강점을 지니지만, 본 연구에서는 상대적으로 문맥 정보가 제한적인 단어형 데이터를 활용했다는 한계가 존재한다. 따라서 향후 더욱 세밀하고 구조화된 사고원인 분류체계로 발전할 수 있도록 다양하고 많은 양의 사고원인 데이터를 지속적으로 수집하여 연구를 진행할 필요가 있으며, 다양한 방식으로 표현되어 있는 정보를 객관적으로 분석할 수 있는 방안을 모색할 필요가 있다.
본 연구는 사고원인 분석 과정이 동종재해의 예방과 안전관리 측면에서 중요한 절차임에도, 실제 활용되는 사고원인 분석기법이 구조화된 일관성 있는 체제로 구축되어 있지 않다는 한계를 보완하기 위하여 진행된 연구이다. 본 연구에서 제안하는 방법론과 분류체계는 향후 사고원인 분석기법의 표준화, 사고원인 데이터의 축적 및 비교, 동종재해의 재발방지에 효과적인 대책 수립의 기초 자료로 활용될 수 있다. 더불어, 정책 수립 및 안전관리 시스템과의 연계를 통해 다양한 산업현장과 작업환경에서 활용할 수 있는 범용적인 사고원인 분류체계로 확장될 수 있는 기반을 마련하였다는데 의의가 있다.
References
1. Angelov, D., Top2Vec: Distributed representations of topics, arXiv preprint arXiv:2008.09470, 2020. doi:10.48550/arXiv.2008.0Angelov, D., Top2Vec: Distributed representations of topics, arXiv preprint arXiv:2008.09470, 2020. doi:10.48550/arXiv.2008.094709470
Google Scholar
PIDS App ServiceClick here!